 Autor:
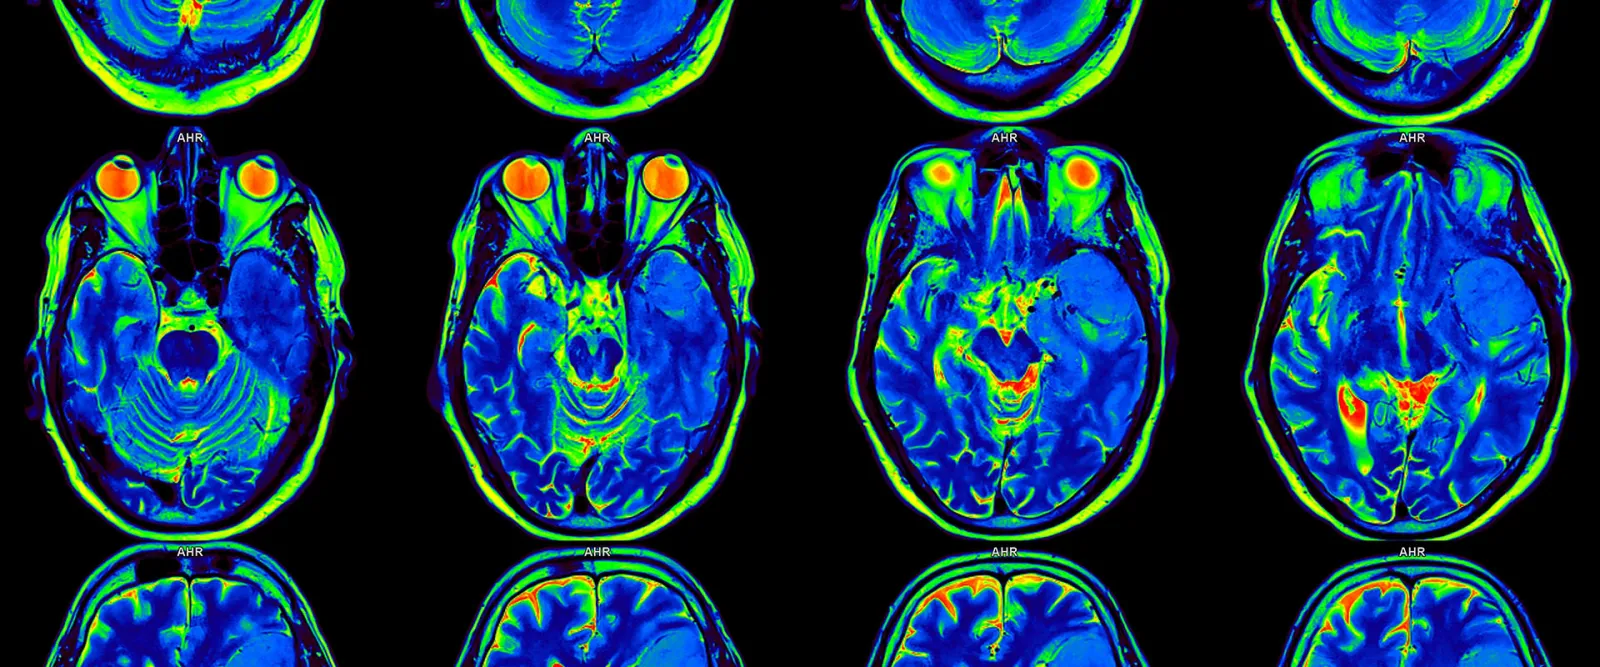
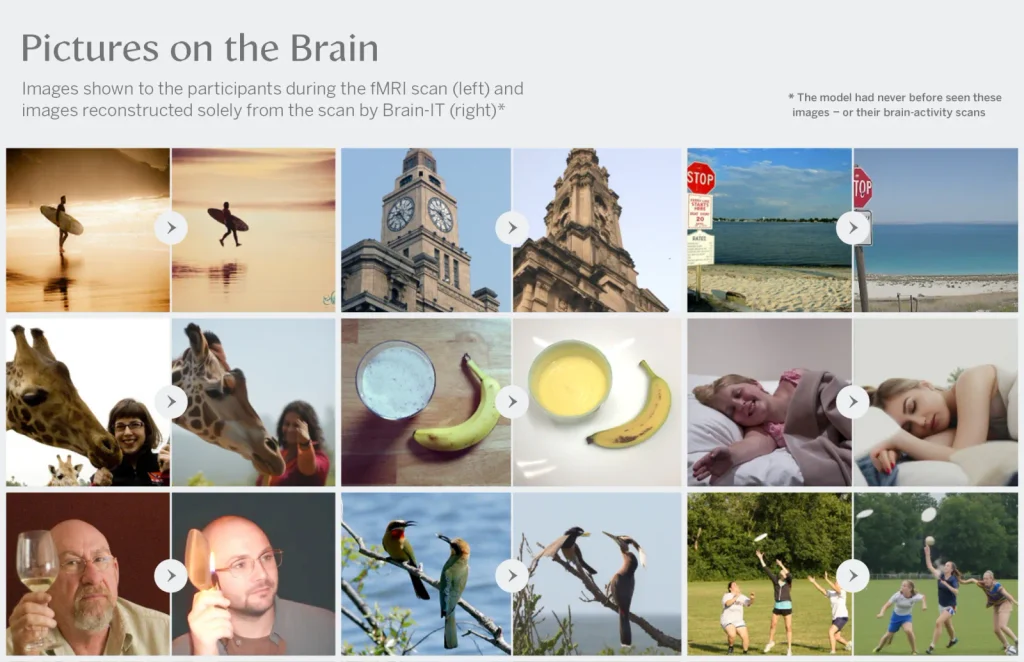
Tehisintellektimudel Brain-IT suudab ajutegevuse põhjal taastada pildi, mida inimene vaatab. Selleks piisab tunni jagu aju-uuringu andmetest.
Tehisintellektimudel Brain-IT suudab ajutegevuse põhjal taastada pildi, mida inimene vaatab. Teadlaste sõnul piisab mudeli kohandamiseks uuele inimesele umbes tunni jagu aju-uuringu andmetest.
Staadion on rahvast täis, pall on õhus ja kõigi pilgud on lööjal, kes valmistub kurikaga palli lööma. Pesapallifännid tunnevad selle vaatepildi kohe ära. Weizmanni teadusinstituudi professori Michal Irani laboris väljatöötatud „mõtteid lugev“ tehisintellektimudel Brain-IT suudab selle stseeni taastada üksnes seda vaatava inimese ajutegevuse põhjal. Brain-IT tunneb ära ajutegevuse mustrid, mis piltide töötlemisel eri inimeste ajus korduvad. Nende ühiste mustrite abil õpib mudel kiiresti uue inimese ajutegevust tõlgendama.
Brain-IT vajab uue inimese puhul tunni jagu ajutegevuse andmeid
Viimastel aastatel on teadlastel õnnestunud aidata raske halvatusega inimestel ajutegevuse “lugemise” põhjal taas kõne abil suhelda. Selleks kasutasid nad iga inimese jaoks kohandatud tehisintellektimudeleid, mille treenimiseks kulus kümneid tunde ajutegevuse salvestisi. Brain-IT kasutab piltide taastamiseks ajutegevuse mustreid, mis korduvad eri inimestel.
„Praegu on olemas mudeleid, mis teisendavad ajutegevuse piltideks. Need võivad anda muljetavaldavaid tulemusi ja tabada üsna hästi, mida algsel pildil kujutati,“ ütleb Irani. „Kuid sageli eksivad need selliste põhitunnuste puhul nagu kompositsioon ja värvid. Meie uus mudel taastab paremini nii pildi sisu kui ka üksikasjad. Pealegi vajavad kõik teised mudelid kümnete tundide jagu ajuskaneeringuid, et õppida uue inimese ajutegevust „lugema“. Meie mudelile piisab ühest tunnist.“
Kuidas tehisintellekti treenimiseks fMRI-andmeid kogutakse?
2026. aastal valiti mudelit käsitlev uurimus esitlemiseks rahvusvahelisel konverentsil International Conference on Learning Representations (ICLR), mis on üks maailma juhtivaid tehisintellektikonverentse. Irani töörühm Weizmanni teadusinstituudi arvutiteaduse ja rakendusmatemaatika osakonnast, kuhu kuulusid Roman Beliy, Amit Zalcher, Jonathan Kogman ja Navve Wasserman, pidi mudelit arendades toime tulema treeningandmete nappusega.
Sellise mudeli treenimiseks on vaja suurel hulgal pilte ning iga pildi juurde andmeid selle kohta, mis toimus katseisiku ajus pilti vaadates. Neid andmeid kogutakse funktsionaalse magnetresonantstomograafia ehk fMRI abil. Selliste andmestike kogumiseks peavad aga paljud katseisikud veetma pikka aega MRI-seadme kitsas tunnelis. Seetõttu sisaldab ka suurim selle valdkonna teadlastele praegu kättesaadav andmestik vaid kaheksa inimese fMRI-uuringute andmeid. Igaüks neist vaatas mitu tuhat pilti. Tehisintellekti treenimiseks on seda siiski vähe.
Kuidas Brain-IT ajutegevusest pilte taastab?
Irani töörühma lahendus meenutab kahesuunalist sõnastikku. Ühes suunas teisendatakse pilt ajutegevuse mustriks, teises suunas taastatakse selle mustri põhjal pilt. Nad töötasid välja nii „dekoodri“, mis õpib fMRI-uuringu andmete põhjal pilti taastama, kui ka „koodri“, mis õpib pildi põhjal ennustama, millist ajutegevust fMRI-uuring selle pildi vaatamise ajal näitaks. Koodrit käsitlev uurimus
„Mõistsime, et kui tõlgime edasi-tagasi – alustame juhuslikust pildist, mida keegi pole fMRI-seadmes vaadanud, ennustame selle põhjal ajuskaneeringu tulemuse ja jõuame siis tagasi algse pildini –, loovad mudelid endale sisuliselt ise tohutu andmestiku,“ selgitab Irani. „Plaan oli anda koodrile pilte, mida polnud kellelegi magnetresonantstomograafis näidatud, lasta seejärel koodril ennustada, mida fMRI nende piltide vaatamisel näitaks, ning anda ennustatud mõõtmistulemused dekoodrile. Dekooder püüaks seejärel nende põhjal algse pildi taastada. Nii õpiksid mudelid looma piisavalt täpseid fMRI-andmeid, et nende järgi saaks pildi taastada ka tegeliku mõõtmiseta.“
40 000 vokslit aitavad leida ühiseid ajutegevuse mustreid
Koodri väljatöötamisel oli suurim raskus inimeste ajude erinevus. Sama pilt võib eri inimestel esile kutsuda erineva ajutegevuse mustri. Teadlased jagasid aju mõõtmisandmed ligikaudu 40 000 voksliks ehk väikeseks kolmemõõtmeliseks ruumielemendiks. Seejärel vaatasid nad, kuidas iga voksli signaal eri piltide vaatamisel muutus.
Samal ajal kasutasid teadlased tehisintellektimudelit, et eristada piltidel nii visuaalseid tunnuseid – näiteks värvi ja pildil olevate objektide asukohta – kui ka sisulisi tunnuseid, näiteks seda, kas pildil on toit või nägu. Nii üksikasjalikus analüüsis hakkasid ilmnema kindlate pilditunnustega seotud ajutegevuse mustrid, mis kordusid eri inimeste ajus. See avastus võimaldas luua universaalse ajutegevuse koodri.
Tehisintellekt eristas 128 pilditöötlusega seotud ajupiirkonda
„Treeningu käigus tuvastas kooder ise 128 kõigile inimestele ühist funktsionaalset ajupiirkonda, millest igaühel on piltide töötlemisel kindel ülesanne,“ selgitab Irani. „Mõned neist on neuroteadlastele juba tuttavad, teised aga täiesti uued. Näiteks avastasime, et kohti kujutavaid pilte töötlevas ajupiirkonnas ehk PPA-s on töö jaotunud nii, et üks osa reageerib siseruumide ja teine väliskeskkonna piltidele.“
„Koodri tugevus on see, et ta suudab eri inimeste ajus leida sarnase ülesandega piirkonnad ka siis, kui nende anatoomiline asukoht erineb,“ lisab ta. „Veel üks eelis on võimalus uurida eri pilditunnuseid kontrollitud tingimustes. Näiteks saab koodrile anda sama pildi nii värvilisena kui ka mustvalgena, võrrelda ennustatud fMRI-tulemusi ja selle põhjal järeldada, kus ajus värviinfot kodeeritakse. Tulevikus võib kooder aidata meil ka mõista, kuidas eri ajupiirkonnad koos töötavad ja kuidas kujuneb taju.“
Kas ajutegevuse põhjal saaks taastada heli või unenägusid?
Irani töörühm uurib praegu, kas sama meetodiga saaks ajutegevuse põhjal tuvastada ka seda, mida inimene kuuleb. Üks võimalik uurimissuund on liikuvate kujutiste taastamine. „Eriti keeruline on endiselt dekodeerida liikuvaid kujutisi, näiteks unenägude ajal,“ selgitab Irani. „Sekundis vaheldub kümneid kaadreid, samas kui fMRI annab uue mõõtmistulemuse umbes iga kahe sekundi järel. Kui suudame kõik need takistused ületada, võime tulevikus ehk isegi unenägusid lugeda.“
Natural Scenes Dataset sisaldab umbes 73 000 pildi ja fMRI-andmete paari
Uuringus kasutatud avalik andmestik Natural Scenes Dataset sisaldab kaheksa osaleja fMRI-andmeid. Iga osaleja vaatas tuhandeid pilte. Andmestiku koostamine oli väga töömahukas. Iga osaleja käis 30–40 mõõtmiskorral. Igal korral tehti kuus umbes kümneminutilist fMRI-skaneeringut. Iga skaneeringu ajal vaatas osaleja ligikaudu 40 pilti. Kokku sisaldab andmestik umbes 73 000 paari, millest igaüks seob pildi selle vaatamise ajal salvestatud fMRI-andmetega.
Allikas: Algartikkel Weizmanni teadusinstituudi veebilehel
Loe lisaks
Inimese aju koosneb kahest kõrvutiolevast elundist
Kuidas aju dementsuse eest kaitsta
Teadlased avastasid ajus kroonilise valu piduri
Stress jätab ajurakkudesse armi
Telerivaatamine teeb aju väiksemaks ja dementseks
C-vitamiin hoiab eaka aju heas vormis
Lihtne molekul puhastab aju Alzheimeri tõvest
Kuidas taastada keskendumisvõime tähelepanu hajumise ajastul